【Kubernetes】Numaflow でストリーミング処理を行う
Kubernetes 上でストリーム処理を組み立てる Numaflow について、入力・処理・出力をつなぐ YAML と、負荷に応じて Pod 数を増やした結果を紹介します。既に Kubernetes のリソースを操作できる読者向けに、各構成要素の役割から説明します。
Numaflow とは
Numaflow は、Kubernetes 上で大規模な並列ストリーム処理を実現するフレームワークです。パイプラインは Kubernetes カスタムリソースとして定義し、入力を受ける Source、ユーザーが書いた処理を実行する UDF、結果を送る Sink の各 Vertex(処理の単位)で構成します。Argo Workflows のように、YAML でパイプラインを記述できます。
利用シーン
- リアルタイムデータ分析アプリケーション
- 異常検出、モニタリング、アラートなどのイベント駆動型アプリケーション
- データ計測・転送などのストリーミングアプリケーション
- ストリーミング方式で実行されるワークフロー
特徴
- Kubernetes ネイティブ: Kubernetes の知識を活かせる
- 言語非依存: 任意のプログラミング言語を使用可能
- Exactly-once セマンティクス(ニアリアルタイムデータソースの場合): Pod の再スケジュール/再起動によるデータ損失や重複なし
- バックプレッシャー対応の自動スケーリング: 各 Vertex はゼロから必要な数まで自動でスケール
データの整合性保証
- At-least-once 配信
- ニアリアルタイムデータソースに対しては Exactly-once セマンティクスを提供
用語
ここでは、パイプライン定義に関する Numaflow の用語を整理します。
パイプライン
データ処理ジョブを定義するもので、Vertex(データ処理タスク)と Edge(Vertex 間の関係)のリストから成ります。Edge では 1 つの Vertex から複数の Vertex への関係を定義でき、v0.10 以降は Join/Cycle により多対一の関係も定義できます。
| pipeline.yaml | |
|---|---|
| pipelineの情報取得 | |
|---|---|
Vertex
パイプラインの構成要素であり、データ処理タスクを担います。
| vertexの情報取得 | |
|---|---|
Vertex Types
Vertex には、役割に応じて次の 3 種類があります。
- Source: データ入力
- Sink: データ出力
- UDF (User Defined Function): データ処理ロジック
Source
データソースから Numaflow へデータを読み込みます。データ変換/フォーマット、Watermark 追跡、遅延データ検出などを行います。
次のような Source Vertex があります。
- Kafka
- HTTP
- Ticker
- Nats
- User Defined Source
User Defined Source は、ユーザーが Numaflow SDK を使って作成するカスタム Source です。プラットフォーム内蔵の Source が対応していないシステムからデータを読み込む場合に使い、正確に一度だけ読み取るための custom acknowledge 管理もサポートしています。
Sink
Sink は処理済みデータの出力先です。データベース、データウェアハウス、可視化ツール、アラートシステムなどがあります。 Source Vertex とは異なり、パイプラインには複数の Sink Vertex を設定できます。
次のような Sink Vertex があります。
- Kafka
- Log
- Black Hole
- User Defined Sink
User Defined Sink は、Numaflow SDK を使って作成できるカスタム Sink です。処理したデータをシステムに出力するときや、必要な変換がプラットフォーム内蔵の Sink ではできないときに使います。例えば、入力メッセージを処理した後、Elasticsearch を User Defined Sink として使うと、処理結果を保存して検索や分析ができます。
UDF(User Defined Functions)
ユーザー定義関数(UDF)は、ユーザーが定義したデータ変換ロジックを実行する Vertex です。UDF でのデータ処理は、べき等であることが前提です。
UDF は Vertex Pod のサイドカーコンテナとして実行され、受信したデータを処理します。メイン・コンテナとサイドカー・コンテナの役割分担は次のとおりです。
| コンテナ | 役割 |
|---|---|
| メイン・コンテナ | プラットフォームのコードを実行する |
| サイドカー・コンテナ | ユーザーのコード(UDF)を実行する |
メイン・コンテナとサイドカー・コンテナは、Unix Domain Socket 上の gRPC で通信します。
ユーザーが実行できる処理には次の 2 種類があります。
- map
- reduce
map の例
公式ドキュメントのMap の Examplesが、偶奇を判定するパイプラインを紹介しています。パイプラインの概要は次の図のとおりです。
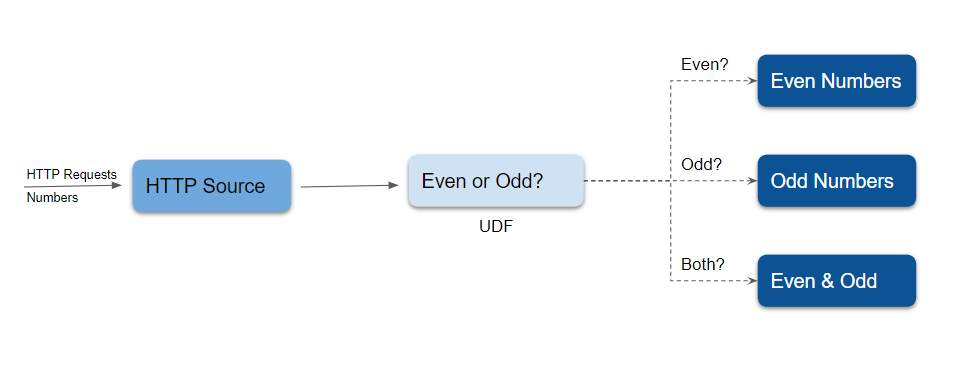
YAML で表すと次のとおりで、各 Edge のconditionsでタグを指定し、該当するタグが付いたデータだけを処理します。
この UDF の実装は、numaflow-go の even_odd サンプルで確認できます。
Auto Scaling
Numaflow は、Horizontal Pod Autoscaling と Vertical Pod Autoscaling の両方で scale out/in できます。
Horizontal Pod Autoscaling
Numaflow でサポートされている Horizontal Pod Autoscaling には、次の方式があります。
- Numaflow Autoscaling
- Kubernetes HPA
- Third-party Autoscaling(KEDA など)
このうち、以下では Numaflow 自身が提供する Numaflow Autoscaling を紹介します。
Numaflow Autoscaling
0 から N までのオートスケーリング機能を Numaflow 自身が提供しており、すべての UDF、Sink、Source Vertex で利用できます。
Joins and Cycles
Vertex 間の関係を柔軟に組み立てるための機能として、Join と Cycle の 2 つを紹介します。
Joins
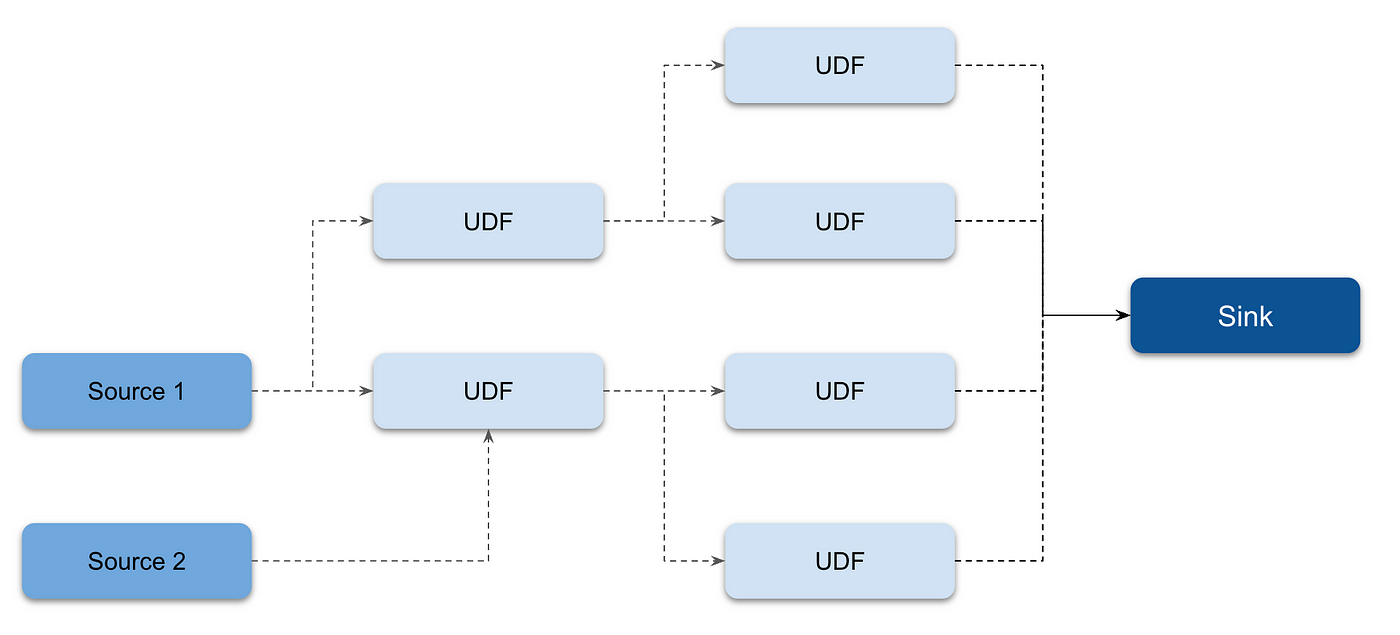
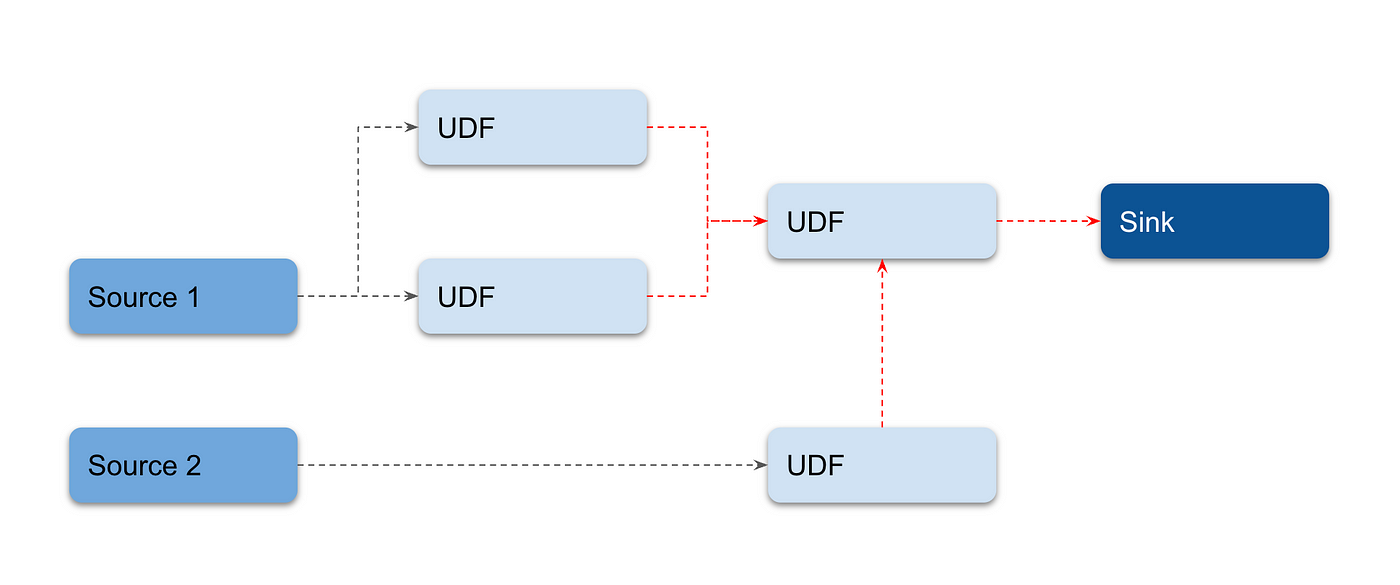
Numaflow では、複数の Vertex から 1 つの Vertex にメッセージを転送できます。この構成は Join と呼ばれ、パイプラインの冗長性を排除できます。 多対一のデータフローをサポートするため、同じジョブを実行する複数の Vertex は不要です。
Join を用いたパイプラインの例を 2 つ示します。
Cycles
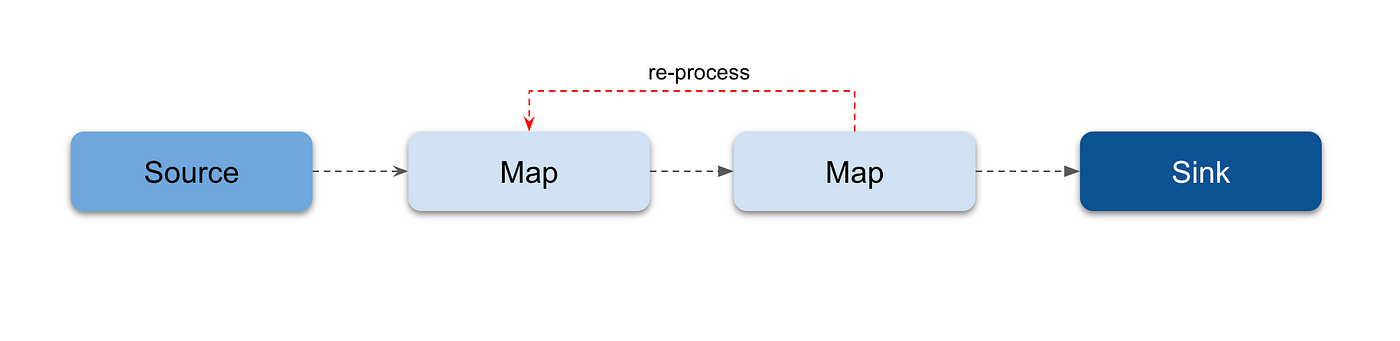
Numaflow では Vertex 間に循環を作成でき、この構成は Cycle と呼ばれます。図で示すと次のようになります。
Quick Start を試す
GKE Autopilot 上でNumaflow の Quick Startを試しました。次の動作確認は、Numaflow のコントローラーと前述のパイプラインをクラスタへ作成済みで、numaflow-systemに UI の Pod が起動している状態を前提とします。
次のコマンドを実行して、https://localhost:8080/にアクセスすると、Numaflow の UI が表示されます。 Cloud Shell からは UI に接続できなかったため、次のコマンドは開発マシンで実行しました。
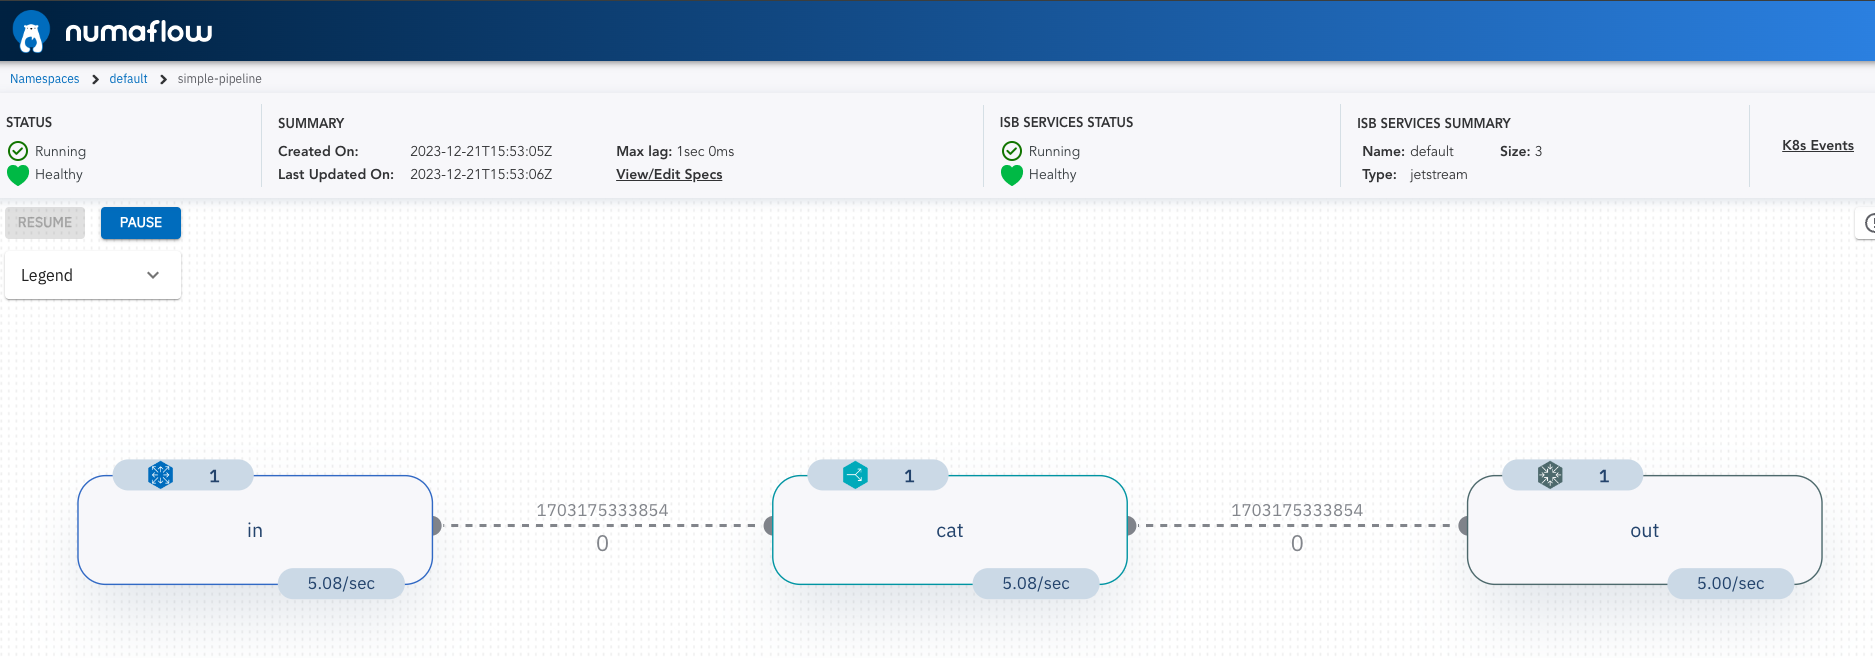
Web UI から YAML を編集してリソースを作成・編集・削除できます。 試しにinの部分の RPS を変更すると scale out して Pod が増えることを確認できました。
まとめ
Numaflow では、Source から UDF、Sink までの接続を Kubernetes カスタムリソースとして宣言的に定義でき、Join や Cycle を使えば多対一や循環を含む複雑なデータフローも表現できます。GKE Autopilot 上の Quick Start では、Web UI でリソースを編集しながら、負荷に応じた scale out を確認できました。Kubernetes の知識を活かしつつ、ストリーミング処理をシンプルな YAML で組み立てたいなら、選択肢の 1 つです。